 RUNNERS / SOLANA
CRAWL : les araignées du web veulent nourrir une IA crypto
Une animation virale devient un réseau de lecteurs, une reine à entraîner et des frais de trading à convertir en calcul. Sur Solana, CRAWLNET atteint un ATH communiqué de 3,78 M$ le 4 octobre à 5 h 58, heure de Paris.
Une araignée quitte sa page Wikipédia
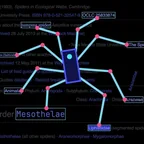
Le 1er octobre, Slava Rybin, @rybinfx, publie une animation intitulée Web spiders. Sur une page sombre remplie de références, une petite créature géométrique accroche ses pattes aux mots et aux liens. Des traits colorés dessinent son déplacement dans le texte. Le profil de Rybin le présente comme un artiste des systèmes ; sa publication porte les hashtags JavaScript et CSS. Avant de devenir un récit de token, l’araignée est une manière de rendre visible et presque animale la navigation dans une page web. [1]
Le 4 octobre à 0 h 06 min 32 s, heure de Paris, Matthew, @matthewabides, cite cette vidéo et propose un changement d’échelle : multiplier les crawlers, leur faire parcourir le web crypto et entraîner un modèle de langage sur leurs lectures. Il affirme avoir construit ce système. À 0 h 09 min 07 s, il ajoute le contrat BXoHJddsWJLHtAopeiSbKUSELsu8hSFMs8baGMDkpump. Ce lien explicite rattache son fil à CRAWLNET sur Solana ; il n’attribue pas à Rybin la création ou le soutien du token. [2] [3]
La mascotte devient une salle de lecture
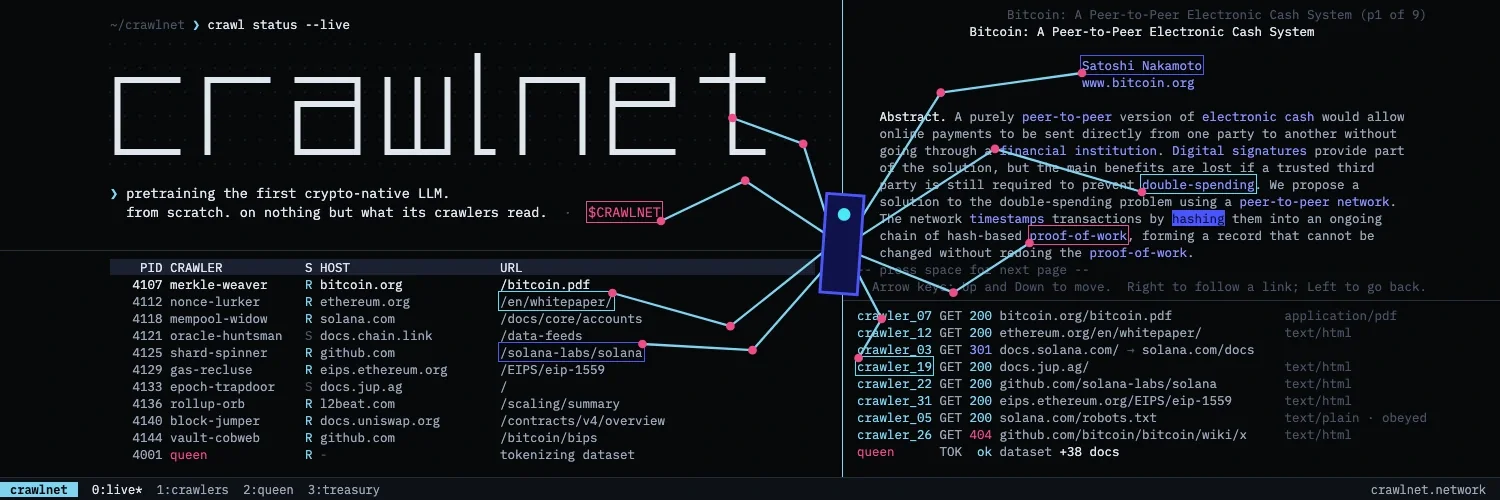
CRAWLNET conserve le plaisir visuel de l’araignée, mais lui donne un travail. La bannière associe un corps rectangulaire bleu-violet, des pattes cyan et des points roses à un extrait du livre blanc de Bitcoin. À gauche, une liste de processus énumère des collecteurs ; à droite, des lignes de journal affichent des lectures. Le visiteur retrouve les codes d’un terminal informatique plutôt que ceux d’une mascotte souriante. L’image transforme une opération invisible en activité que l’on peut regarder. [17]
Le site poursuit ce choix avec des rubriques live, crawlers, queen, treasury et spawn. Queen désigne le modèle auquel les lectures doivent servir. La proposition relie trois choses habituellement séparées : les documents de projets crypto, la fabrication d’un jeu de données et le financement d’une expérience d’IA par les frais créateur d’un memecoin. Notre lecture est que l’attrait ne tient pas seulement au résultat promis : chaque collecte fournit aussi un petit épisode public de l’histoire. [4]
Lire n’est pas encore apprendre
Dans son fil, Matthew décrit chaque collecteur comme un navigateur Chromium sans interface, piloté par un agent DeepSeek. Il indique qu’il lit aussi les PDF et écarte les pages étrangères à la crypto ou au web3. Le manuel précise la suite : normaliser les pages, supprimer les doublons, filtrer leur pertinence et transformer le texte en unités utilisables pour l’entraînement. Il organise les cibles en chapitres, parmi lesquels livres blancs, documentation, forums et GitHub. Ce sont les mécanismes décrits par le projet, pas un audit de leur exécution. [5] [8]
La distinction entre le collecteur et Queen est essentielle. DeepSeek est présenté comme le guide de navigation ; Queen doit, elle, être préentraînée à partir d’une initialisation aléatoire sur le corpus constitué. Matthew annonce une première version de 42 millions de paramètres demandant au moins 20 millions de tokens uniques, puis une échelle allant jusqu’à 1,68 milliard de paramètres. Ici, tokens signifie fragments de texte pour l’IA, pas unités de CRAWL achetées sur Solana. Ces tailles sont des objectifs annoncés. [6]
La référence à nanochat apporte un contexte technique réel. Le dépôt d’Andrej Karpathy rassemble les étapes de tokenisation, préentraînement, ajustement, évaluation et inférence pour des modèles accessibles à l’expérimentation. S’en inspirer n’établit ni une participation de Karpathy à CRAWLNET ni une performance équivalente aux modèles cités. Une collecte qui grossit et un modèle qui répond bien restent deux résultats à démontrer séparément. [7]
Des frais, des GPU et des parts de collecte
Le manuel décrit une répartition des frais créateur de Pump.fun : 80 % financeraient les navigateurs, les modèles utilisés pour collecter et les entraînements sur GPU ; 20 % alimenteraient un pool destiné aux propriétaires de crawlers. Pour participer, le visiteur doit brûler des CRAWL afin de faire apparaître un collecteur lié à son portefeuille. Ce mécanisme transforme le personnage en contribution identifiable et promet une rémunération de son activité. Détenir simplement le token n’est pas présenté comme suffisant pour recevoir une part. [8] [10]
Les conditions ont cependant changé entre les sources. Le fil de lancement parle d’un million de CRAWL brûlés par collecteur et d’un partage toutes les vingt-quatre heures. Le manuel consulté le 4 octobre prévoit des cycles de douze heures, clos à 0 h et 12 h UTC, avec au moins vingt-cinq nouvelles pages apportées dans le cycle pour être éligible. À 9 h 44, le compte @crawlnetwork annonce cinq nouveaux collecteurs et un coût de 200 000 CRAWL chacun. Il faut donc lire ces règles avec leur date, plutôt que transformer la première annonce en condition permanente. [8] [9] [16]
Les distributions en SOL et le registre de trésorerie sont des éléments annoncés par la plateforme. Les sources examinées ici ne constituent pas une vérification indépendante de chaque paiement ni de l’affectation complète des frais. Leur intérêt narratif est plus précis : les lecteurs sont invités à financer des heures de calcul tout en suivant la contribution de machines portant leur nom. [10]
Dans les réponses, l’expérience rencontre sa concurrence
À 0 h 22 min 04 s, leyten évoque la possibilité d’un modèle financé par un memecoin et encourage Matthew. C’est une appréciation de participant, pas la preuve que CRAWLNET serait le premier à le faire. Une minute auparavant, Jud, @judthedev, comparait déjà le projet à un autre site qu’il juge moins bon. Sans contrat concurrent dans cette réponse, elle ne permet pas de reconstituer une identité commune ; elle montre que la question de l’antériorité entre immédiatement dans la discussion. [11] [12]
Les critiques portent aussi sur le travail promis. À 3 h 06 min 43 s, Anderson, @ItsGoharr, met en doute la qualité de la matière collectée. La remarque vise une vraie question du projet : un corpus exclusivement crypto peut contenir documentation technique, promotion et récits intéressés. Le filtrage annoncé doit donc faire davantage qu’additionner des pages. À 3 h 00 min 32 s, 0xTantei demandait de son côté à Matthew ce qui différencie ce projet de SWARM, en citant un ancien message sur un token Robinhood. Cette interrogation sur la continuité ne démontre pas un abandon ; elle rappelle que les participants évaluent aussi l’historique d’un auteur. [13] [14]
À 5 h 58, le sommet précède encore le premier entraînement annoncé
L’ATH communiqué à la rédaction pour ce contrat est de 3,78 millions de dollars de capitalisation le 4 octobre à 5 h 58, heure de Paris. DEX Screener situe la paire Pump.fun à 0 h 07 min 49 s et la paire PumpSwap suivie à 0 h 08 min 10 s. Ces repères documentent les marchés ; ils ne mesurent pas le poids de chaque relais dans la hausse. [17]
À 8 h 28 min 30 s, donc après ce sommet, le compte Crawlnet annonce avoir atteint le seuil de données de Queen v1 : 20,7 millions de tokens uniques issus de 8 255 pages. Son message présente le préentraînement comme l’étape suivante. Il ne faut donc pas relire le maximum de capitalisation comme la validation d’un modèle déjà achevé à cette heure. La promesse de publier les poids sur Hugging Face appartient également au programme annoncé. [2] [15]
Lors de notre consultation, la vue publique restait en reconnexion et ne permettait pas de contrôler en direct ces compteurs ni une réponse de Queen. CRAWLNET dispose pourtant déjà d’un récit distinct : une araignée issue d’une animation devient une équipe de lecteurs, puis une expérience d’apprentissage financée par son marché. La prochaine étape sera de comparer les données, les poids publiés et les réponses du modèle, pour voir ce que ces lectures auront réellement produit. [4] [18]
Sources
Sources consultées le 4 octobre 2026. Les chiffres décrivent les relevés cités et ne sont pas actualisés en direct.
- Slava Rybin — animation Web spiders, 1er octobre
- Matthew — présentation de Crawlnet, 4 octobre à 00:06 (Paris)
- Matthew — contrat exact de CRAWL, 4 octobre à 00:09 (Paris)
- CRAWLNET — site et interface publique
- Matthew — collecte, Chromium et DeepSeek
- Matthew — échelle de modèles et besoins en données
- Andrej Karpathy — dépôt officiel nanochat
- CRAWLNET — manuel de collecte et économie
- Matthew — lancement des crawlers et partage des frais
- CRAWLNET — trésorerie et distributions annoncées
- leyten — réaction sur le financement du modèle par un memecoin
- Jud — comparaison avec un autre site, réponse à Matthew
- Anderson — critique de la qualité des données collectées
- 0xTantei — question sur la continuité après SWARM
- Crawlnet — seuil de données v1 annoncé, 4 octobre à 08:28 (Paris)
- Crawlnet — nouveaux crawlers et coût annoncé, 4 octobre à 09:44 (Paris)
- DEX Screener — CRAWL / SOL sur PumpSwap, identité et visuels
- CRAWLNET — interface Queen